一图文秒懂 向量数据库、数据库发展过程与数据库服务
在人工智能应用井喷的今天,“向量数据库”成为高频热词。但你真的了解它吗?它和传统数据库是什么关系?数据库服务又指什么?本文用最直观的图文逻辑,带你一口气看懂数据库的演进、向量数据库的独特价值,以及数据库服务的形态。
一、数据库发展过程:从表格到向量
数据管理需求推动了数据库技术的三次大跃迁:
1.0 时代:关系型数据库(1970s)
- 代表:MySQL、Oracle、PostgreSQL
- 数据结构:二维表(行×列),严格Schema
- 擅长:事务处理(ACID)、结构化查询(SQL)
- 痛点:难以处理非结构化数据(文本、图像、音频)
2.0 时代:NoSQL与搜索引擎(2000s)
- 类型:键值(Redis)、文档(MongoDB)、图(Neo4j)、宽列(Cassandra)
- 搜索引擎:Elasticsearch(倒排索引,支持全文检索)
- 进步:处理半/非结构化数据,高扩展性
- 局限:语义理解仍然基于关键词匹配
3.0 时代:向量数据库(2010s后期至今)
- 核心:存储高维向量(Embedding),基于相似度检索
- 代表:Milvus、Pinecone、Weaviate、Qdrant、Faiss
- 突破:真正理解“语义相似”,支撑AI应用
▶ 关键驱动力: 深度学习模型(如BERT、CLIP、GPT)能把文本、图片、音视频转换成高维向量,向量之间的距离代表语义相似度。传统数据库无法高效处理这种“向量相似性搜索”。
二、向量数据库:AI时代的记忆库
定义: 专门用于存储、索引和查询高维向量数据的数据库系统,核心能力是近似最近邻搜索(ANN) ,在毫秒级内从亿级向量中找到与查询向量最相似的Top-K结果。
▶ 一图秒懂原理(文字版脑补):
1. 数据转向量(Embedding):文本“猫” → [0.2, -0.5, 1.3, …](1024维)
2. 存向量:向量数据库将向量写入并建立索引(如HNSW、IVF)
3. 查询:以“猫咪”向量搜索 → 计算余弦相似度或欧氏距离 → 返回最接近的向量ID与物体
核心组件对比:
| 特性 | 传统数据库 | 向量数据库 |
|------|-----------|------------|
| 数据类型 | 数字、文本、日期 | 高维浮点向量 |
| 查询方式 | 精准匹配(WHERE a=1) | 相似度搜索(近似最近邻) |
| 索引结构 | B+树、哈希 | HNSW、IVF-PQ、DiskANN |
| 延迟 | милли秒级(点查) | 毫秒级(ANN检索) |
| 典型场景 | 记账、订单 | 推荐、图像检索、RAG |
为什么不是简单加个向量索引? 主流关系库(PG)通过pgvector可支持向量,但专用向量库在海量数据、存算分离、混合过滤、分布式扩展上优势明显。
三、数据库服务:从自建到云原生
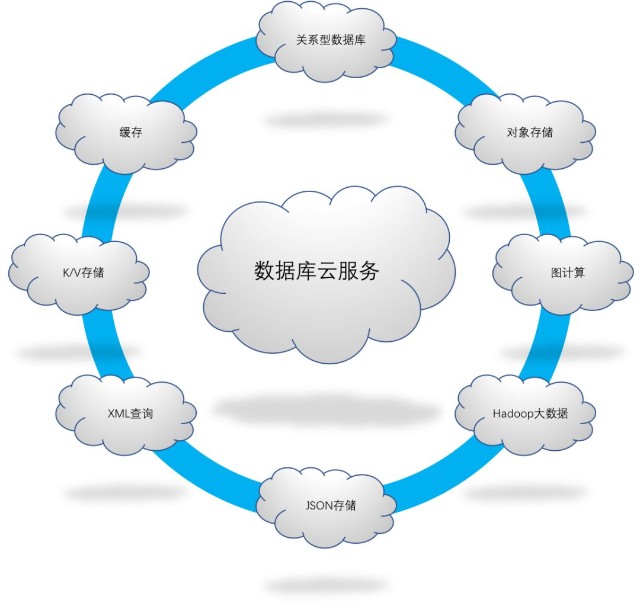
“数据库服务”通常指以服务化形式交付的数据库能力,免去用户的安装、运维、调优负担。常见形态:
1. 云数据库(DBaaS)
- 如Amazon RDS、阿里云RDS、腾讯云TDSQL
- 按需付费、自动备份、高可用
- 覆盖关系型、NoSQL
2. 向量数据库服务
- 全托管:Pinecone、Zilliz Cloud(Milvus托管版)、腾讯云VectorDB
- 半托管:自建Milvus + 云存储
- 特点:按向量存储量和查询量计费,内置Embedding和RAG流水线支持
3. Serverless数据库服务
- 如Aurora Serverless、Neon、MongoDB Atlas Serverless
- 自动扩缩容,用多少付多少,适合突发流量
▶ 企业如何选择?
- 数据量小、已有云设施 → 在PostgreSQL+pgvector上做服务
- 海量向量、高并发、低延迟 → 启用专业向量数据库服务
- 初创快速上线 → Serverless向量服务(零运维)
四、一图梳理关系
我们可以把整个体系比喻为“一整个图书馆”:
- 关系数据库:卡片目录,按编号查书(精确)
- NoSQL/搜索:读者评论、目录全文检索(关键词)
- 向量数据库:当你说“找一本类似本书书精神的”,管理员你能依据“感觉”推同类(语义)
- 数据库服务:是你如何获取图书馆服务——自己修、还是购买云上的“会员服务”。
一句话:向量数据库是应AI而生的数据库3.0;数据库发展是从表格到文档,再到向量的过程;数据库服务,是让任何企业通过云平滑用上这些能力的行为方式和产品形态。不理解它们,就会被智能时代的应用困在入口。
如若转载,请注明出处:http://www.chnopener.com/product/51.html
更新时间:2026-09-18 20:54:41